Hari 1 — Kenapa NoSQL Muncul, RDBMS vs NoSQL, CAP Theorem
Senin, 2 jam. Konsep murni — belum menyentuh MongoDB/Redis, membangun kerangka berpikir dulu sebelum masuk tool spesifik.
Tujuan Belajar
- Menjelaskan masalah konkret yang mendorong munculnya NoSQL (skema kaku, scalability horizontal)
- Membandingkan RDBMS vs NoSQL pada dimensi: skema, scalability, konsistensi, relasi
- Menjelaskan CAP theorem dan implikasi trade-off-nya
- Menempatkan
pg-belajar(RDBMS yang sudah dipakai 7 minggu) dalam konteks perbandingan ini, bukan menganggapnya “kalah” oleh NoSQL
Untuk Instruktur
Risiko terbesar sesi ini: peserta menyimpulkan “NoSQL lebih modern jadi lebih baik”. Luruskan sejak awal — RDBMS (yang sudah dipakai sejak Minggu 1) tidak digantikan NoSQL, keduanya menjawab kebutuhan yang berbeda. Tekankan: kalau dim_product dan fact_sales (Minggu 3) bekerja baik di PostgreSQL selama ini, itu bukan kebetulan — datanya memang terstruktur & punya relasi jelas, kasus ideal untuk RDBMS.
Konsep & Sintaks
Masalah Konkret yang Mendorong NoSQL
Dua masalah utama yang muncul saat sistem berkembang besar, keduanya sulit dijawab RDBMS tradisional:
1. Skema kaku (rigid schema) — RDBMS mengharuskan struktur tabel didefinisikan di depan (CREATE TABLE dengan kolom & tipe data tetap). Ini bagus untuk data yang benar-benar seragam (semua baris dim_customer selalu punya customer_id + country, tidak ada variasi struktural) — tapi jadi masalah untuk data yang variatif per jenis. Bayangkan dim_product di roadmap ini: produk elektronik butuh warranty_period, produk fashion butuh size_variant, produk buku butuh author/isbn — memaksakan semua ke 1 tabel kaku berarti puluhan kolom yang mayoritas NULL untuk sebagian besar baris, atau desain tabel terpisah per kategori yang rumit di-maintain & di-query lintas kategori.
2. Scalability horizontal — RDBMS tradisional secara historis didesain untuk scale up (mesin tunggal yang diperbesar — lebih banyak CPU/RAM/disk di 1 server, seperti pg-belajar sejak Minggu 1). Untuk beban yang sangat besar (jutaan request per detik, data terabyte-petabyte), scale up ada batasnya (mesin sebesar apapun akhirnya mentok) dan mahal. Banyak sistem NoSQL didesain sejak awal untuk scale out (menambah lebih banyak mesin biasa yang bekerja bersama) — lebih murah & tidak ada batas teoritis, dengan trade-off kompleksitas konsistensi data (dibahas CAP theorem di bawah).
RDBMS vs NoSQL
RDBMS (pg-belajar, dipakai sejak Minggu 1) | NoSQL | |
|---|---|---|
| Skema | Tetap, didefinisikan di depan (CREATE TABLE) | Fleksibel — bisa berbeda struktur antar baris/dokumen dalam koleksi yang sama |
| Relasi antar entitas | Native lewat JOIN, foreign key (star schema Minggu 3 mengandalkan ini penuh) | Umumnya dihindari/diminimalkan — data yang sering diakses bersama cenderung digabung jadi 1 unit (dibahas hari_3_mongodb.md: embedding) |
| Konsistensi | ACID kuat secara default (transaksi, constraint) | Bervariasi — banyak NoSQL memilih model konsistensi lebih longgar demi performa/skala (dibahas CAP theorem) |
| Scaling khas | Vertikal (scale up) secara tradisional | Horizontal (scale out) secara desain |
| Cocok untuk | Data terstruktur dengan relasi jelas & butuh konsistensi kuat (transaksi finansial, fact_sales/dim_*) | Data semi-terstruktur/variatif, butuh skala sangat besar, atau pola akses sangat spesifik (caching, key-value cepat) |
Poin penting: “NoSQL” bukan 1 jenis database — ini payung untuk banyak tipe berbeda (dibahas detail hari_2_tipe_nosql.md), masing-masing dengan trade-off sendiri. Menyebut “pakai NoSQL” tanpa spesifik tipe-nya seperti bilang “pakai software” — terlalu umum untuk jadi keputusan desain.
CAP Theorem
Untuk sistem database terdistribusi (data tersebar di banyak mesin — relevan untuk NoSQL yang didesain scale out), CAP theorem menyatakan: sistem hanya bisa menjamin maksimal 2 dari 3 properti berikut secara bersamaan, terutama saat terjadi network partition (gangguan komunikasi antar mesin dalam cluster):
- C — Consistency: semua node membaca data versi terbaru yang sama, tidak ada node yang menampilkan data basi.
- A — Availability: setiap request selalu mendapat respons (tidak error/timeout), walau mungkin datanya tidak 100% terbaru.
- P — Partition Tolerance: sistem tetap berfungsi meski ada gangguan komunikasi antar node (network partition).
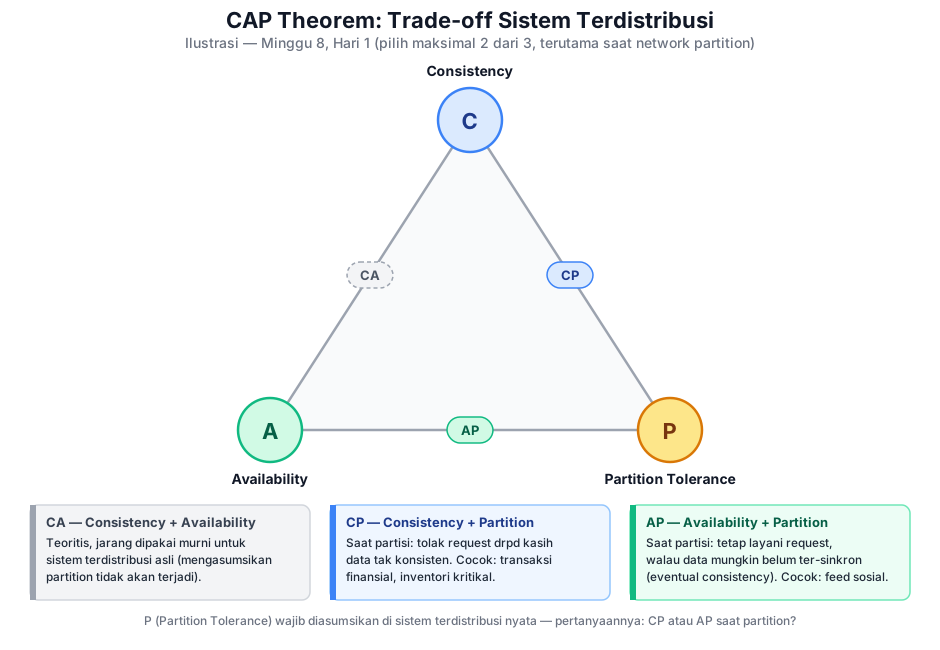
Kenapa cuma “2 dari 3”, bukan pilih bebas ketiganya: dalam sistem terdistribusi nyata, network partition pasti bisa terjadi (jaringan antar server bukan sesuatu yang 100% bisa dijamin selalu sempurna) — jadi P praktis selalu harus diasumsikan bisa terjadi. Pertanyaan sesungguhnya bukan “pilih 2 dari 3”, tapi: saat partition benar-benar terjadi, sistem memilih tetap Consistent (menolak melayani request yang datanya berisiko basi) atau tetap Available (tetap melayani, walau ada risiko data yang dibaca belum sepenuhnya ter-sinkron)?
- CP (Consistency + Partition Tolerance): saat partition terjadi, sistem lebih memilih menolak request daripada memberi data yang berpotensi tidak konsisten. Cocok untuk data yang tidak boleh salah (transaksi finansial, inventori kritikal).
- AP (Availability + Partition Tolerance): saat partition terjadi, sistem tetap melayani request, dengan konsekuensi data yang dibaca mungkin belum ter-update penuh di semua node (eventual consistency — akhirnya akan konsisten, tapi tidak instan). Cocok untuk data yang lebih penting selalu bisa diakses daripada selalu 100% real-time-akurat (feed media sosial, hitungan “like”).
Konteks penting untuk minggu ini: MongoDB dan Redis yang akan dipakai di mini project (Sabtu-Minggu) dijalankan sebagai 1 instance tunggal di Docker lokal — CAP theorem secara ketat cuma relevan untuk cluster terdistribusi (banyak node). Tapi konsepnya tetap penting dipahami karena: (1) kedua tool ini bisa dikonfigurasi sebagai cluster terdistribusi di production sungguhan, dan defaultnya condong ke sisi tertentu (MongoDB defaultnya lebih ke arah CP untuk replica set-nya, Redis Cluster lebih ke arah AP) — (2) ini kerangka berpikir yang akan terus dipakai sepanjang karier data engineering, jauh melampaui roadmap 8 minggu ini.
Kesalahan Umum
- Menyimpulkan “NoSQL lebih modern, jadi selalu lebih baik dari RDBMS”. Keduanya menjawab kebutuhan berbeda —
fact_sales/dim_*(Minggu 3) bekerja baik di PostgreSQL justru karena datanya terstruktur & berelasi jelas, bukan karena “belum sempat pindah ke NoSQL”. - Mengira CAP theorem berarti sistem harus permanen memilih 1 sisi selamanya. Trade-off ini relevan saat partition terjadi — di kondisi normal (tidak ada gangguan jaringan), banyak sistem terdistribusi bisa memberikan konsistensi dan ketersediaan yang baik sekaligus; CAP theorem soal apa yang dikorbankan spesifik saat ada gangguan.
- Menganggap “skema fleksibel” NoSQL berarti “tidak perlu desain skema sama sekali”. Skema tetap perlu dirancang dengan sengaja (dibahas
hari_3_mongodb.md) — fleksibel berarti strukturnya bisa bervariasi antar dokumen, bukan berarti tidak ada rencana struktur sama sekali (skema “acak-acakan” tetap akan menyulitkan query & maintenance jangka panjang). - Mengira semua NoSQL sama soal konsistensi. Ada NoSQL yang tetap menawarkan konsistensi kuat untuk kasus tertentu (MongoDB, misalnya, punya jaminan konsistensi kuat di level 1 dokumen) — CAP theorem soal trade-off di level sistem terdistribusi, bukan berarti semua operasi NoSQL otomatis “longgar”.
Latihan
fact_sales/dim_customer/dim_product/dim_date(Minggu 3) sudah bekerja baik di PostgreSQL selama 7 minggu roadmap ini. Jelaskan kenapa struktur data ini cocok untuk RDBMS — sebutkan minimal 2 karakteristik data yang mendukung argumen ini.- Sebuah startup e-commerce ingin menyimpan inventori stok real-time — sistem harus selalu menampilkan angka stok yang benar-benar akurat, dan lebih baik menolak transaksi daripada menjual barang yang stoknya sebenarnya sudah habis (karena data belum ter-sinkron). CP atau AP yang lebih cocok? Jelaskan.
- Sebuah aplikasi menyimpan jumlah “like” di sebuah postingan, ditampilkan ke jutaan user. Kalau ada gangguan jaringan sesaat antar server, aplikasi lebih baik tetap menampilkan angka like (meski mungkin sedikit basi beberapa detik) daripada menampilkan error “tidak bisa memuat”. CP atau AP yang lebih cocok? Jelaskan bedanya dengan skenario nomor 2.
- Kenapa CAP theorem kurang relevan secara ketat untuk
mongo-belajar/redis-belajaryang dijalankan sebagai 1 container Docker lokal di mini project minggu ini — dan dalam skenario apa dia akan menjadi relevan?
Kunci Jawaban & Pembahasan
1. Data ini cocok untuk RDBMS karena: (a) strukturnya konsisten & seragam antar baris — setiap baris fact_sales selalu punya kolom yang sama (invoice, stock_code, customer_id, quantity, dst), tidak ada variasi struktural antar baris; (b) relasinya eksplisit & penting untuk query — star schema (Minggu 3) secara sengaja dirancang di atas JOIN antara fact dan dimension table, kemampuan JOIN native RDBMS langsung dimanfaatkan; (c) butuh konsistensi kuat — data revenue/quantity yang salah/tidak konsisten berdampak langsung ke keakuratan laporan bisnis (RFM, top produk), RDBMS dengan ACID menjamin ini secara default tanpa usaha ekstra.
2. CP lebih cocok. Untuk inventori stok, konsistensi lebih penting daripada ketersediaan — sistem yang menampilkan stok “tersedia” padahal sebenarnya sudah habis (karena data belum ter-sinkron di semua node, kasus AP) bisa menyebabkan overselling (menjual barang yang tidak ada), masalah bisnis nyata yang lebih mahal diperbaiki daripada request yang sesaat gagal/lambat. Sistem CP akan menolak/menunda transaksi saat ada ketidakpastian data akibat partition, memastikan tidak ada penjualan berdasarkan data stok yang salah.
3. AP lebih cocok, beda dari skenario nomor 2 karena konsekuensi data yang sedikit “basi” jauh lebih ringan — user yang melihat jumlah like “999” padahal sebenarnya sudah “1002” beberapa detik yang lalu tidak menyebabkan kerugian nyata apapun, sementara aplikasi yang tiba-tiba error/tidak bisa dimuat untuk jutaan user karena gangguan jaringan sesaat adalah pengalaman pengguna yang jauh lebih buruk. Ini contoh nyata kenapa keputusan CP vs AP tergantung konteks data & konsekuensi bisnisnya — bukan pilihan teknis universal, harus dipertimbangkan kasus per kasus (skenario 2 = konsekuensi finansial nyata dari data salah, skenario 3 = konsekuensi minimal dari data sedikit basi).
4. CAP theorem soal trade-off dalam sistem terdistribusi (data tersebar di banyak node/mesin) — mongo-belajar/redis-belajar yang dijalankan sebagai 1 instance tunggal di 1 container tidak punya node lain untuk mengalami “network partition” sama sekali, jadi pertanyaan “CP atau AP saat partition” tidak benar-benar berlaku di setup ini. Trade-off ini akan menjadi sangat relevan kalau setup ini di-upgrade jadi cluster terdistribusi sungguhan di production (MongoDB replica set di banyak server, Redis Cluster di banyak node) — situasi yang di luar cakupan roadmap 8 minggu ini, tapi konsepnya tetap penting dipahami sejak sekarang karena ini keputusan arsitektural besar yang akan dihadapi kalau sistem ini benar-benar melayani traffic production sungguhan di masa depan.