Sabtu–Minggu — Capstone: MongoDB, Redis, dan Penutup Portfolio 8 Minggu
Sabtu 4 jam + Minggu 4 jam. Kelanjutan langsung minggu_8.md bagian “Mini Project (Capstone): Polyglot Storage Strategy” — upgrade terakhir dari materi/minggu_7/latihan_containerization_mini_project.md.
Repo yang sama, commit terakhir: tetap
ecommerce-etl-pipeline. Tidak ada layanan cloud baru (semua lokal via Docker, konsisten dengan Minggu 7) — fokus minggu ini murni menambah 2 tool NoSQL dan menulis dokumen strategi yang menyatukan seluruh arsitektur 8 minggu.
Tujuan Belajar
- Memigrasikan
dim_productke MongoDB dengan atribut fleksibel per kategori, dan menulis query yang memanfaatkan fleksibilitas itu - Mengimplementasikan caching layer Redis (pola cache-aside) untuk query yang sudah dikenal mahal sejak Minggu 1-2
- Mengukur & mendokumentasikan perbandingan performa query langsung vs lewat cache
- Menulis
STORAGE_STRATEGY.mdyang menjelaskan seluruh keputusan arsitektur polyglot 8 minggu, danREADME.mdfinal yang merangkum perjalanan lengkap
Untuk Instruktur
Ini sesi penutup — selain hands-on teknis, dorong peserta melakukan retrospektif eksplisit: buka kembali README.md dari Minggu 1-2, lihat seberapa jauh repo ini berkembang. STORAGE_STRATEGY.md dan section “Project Journey” di README final adalah bagian yang paling berharga untuk portfolio/interview — alokasikan waktu cukup untuk itu, jangan sampai terpotong karena keasyikan debugging teknis MongoDB/Redis.
Bagian 1 (Sabtu, 4 jam): MongoDB untuk Data Semi-Structured
Tahap 1: Migrasi dim_product dengan Atribut Fleksibel (±2.5 jam)
Catatan penyesuaian penting: Online Retail II (dataset yang dipakai sejak Minggu 2) tidak punya kolom kategori asli — cuma Description bebas teks (mis. "WHITE HANGING HEART T-LIGHT HOLDER"). minggu_8.md meminta atribut bervariasi “misal elektronik punya warranty_period, fashion punya size_variant” sebagai contoh ilustratif — supaya latihan ini tetap bisa menunjukkan fleksibilitas document model secara nyata, kategori diturunkan dari Description lewat pencocokan kata kunci sederhana (heuristik, bukan data kategori asli yang akurat). Ini keputusan yang sama semangatnya dengan “SCD Type 1 disederhanakan” (Minggu 3) — didokumentasikan eksplisit sebagai simplifikasi, bukan disembunyikan seolah itu kategori resmi dari sumber data.
nosql/mongo_migration.py:
import re

import pandas as pd
from pymongo import MongoClient

WAREHOUSE_DIR = "data/warehouse"

# Heuristik sederhana: cocokkan kata kunci di Description ke kategori & atribut tambahan.
# CATATAN: ini BUKAN kategori asli dari sumber data (Online Retail II tidak punya kolom
# kategori) -- didekati dari kata kunci untuk keperluan LATIHAN document model saja.
CATEGORY_RULES = [
    (r"LIGHT|LAMP|CANDLE|HOLDER", "Home Decor", {"material": "unknown"}),
    (r"MUG|CUP|KITCHEN|BOWL|PLATE", "Kitchen & Dining", {"dishwasher_safe": None}),
    (r"BAG|BACKPACK|POUCH", "Bags & Accessories", {"size_variant": ["S", "M", "L"]}),
    (r"CARD|GIFT|WRAP|RIBBON", "Stationery & Gift", {"gift_wrap_available": True}),
]
DEFAULT_CATEGORY = "Other"


def derive_category(description: str) -> tuple[str, dict]:
    desc = (description or "").upper()
    for pattern, category, extra_attrs in CATEGORY_RULES:
        if re.search(pattern, desc):
            return category, extra_attrs
    return DEFAULT_CATEGORY, {}


def main():
    dim_product = pd.read_parquet(f"{WAREHOUSE_DIR}/dim_product")

    client = MongoClient("mongodb://localhost:27017/")
    db = client["ecommerce_catalog"]
    products = db["products"]
    products.delete_many({})  # idempotent -- migrasi ulang tidak menumpuk duplikat

    documents = []
    for _, row in dim_product.iterrows():
        category, extra_attrs = derive_category(row["description"])
        doc = {
            "_id": row["stock_code"],
            "description": row["description"],
            "category": category,
            **extra_attrs,   # <- INILAH inti document model: field berbeda per kategori
        }
        documents.append(doc)

    products.insert_many(documents)
    print(f"Termigrasi: {len(documents)} produk ke MongoDB koleksi 'products'")

    for category, *_ in CATEGORY_RULES + [(None, DEFAULT_CATEGORY, {})]:
        pass
    summary = products.aggregate([{"$group": {"_id": "$category", "count": {"$sum": 1}}}])
    for row in summary:
        print(f"  {row['_id']}: {row['count']} produk")


if __name__ == "__main__":
    main()
Jalankan:
python nosql/mongo_migration.py
Query yang Menunjukkan Keunggulan Document Model (±1.5 jam)
Simpan sebagai bagian dokumentasi di README.md atau nosql/, jalankan lewat mongosh/pymongo:
# 1. Semua produk kategori "Bags & Accessories" -- field `size_variant` cuma ADA
#    di kategori ini, tidak ada di dokumen kategori lain (tidak perlu kolom NULL
#    di semua baris seperti kalau ini RDBMS)
list(products.find({"category": "Bags & Accessories"}))

# 2. Produk yang punya field `gift_wrap_available` -- query berdasarkan KEBERADAAN
#    field, sesuatu yang canggung dilakukan di RDBMS kaku (mis. WHERE col IS NOT NULL
#    di kolom yang cuma relevan untuk sebagian kecil baris)
list(products.find({"gift_wrap_available": {"$exists": True}}))

# 3. Ringkasan jumlah produk per kategori (setara GROUP BY)
list(products.aggregate([
    {"$group": {"_id": "$category", "total": {"$sum": 1}}},
    {"$sort": {"total": -1}},
]))
Diskusikan (tulis 2-3 kalimat di README): kalau ini dipaksakan di PostgreSQL sebagai 1 tabel dim_product, berapa banyak kolom NULL yang akan muncul untuk produk yang tidak punya atribut kategori tertentu? Bandingkan dengan MongoDB yang cuma menyimpan field yang relevan per dokumen.
Deliverable Sabtu
nosql/mongo_migration.pyjalan sukses, koleksiproductsdi MongoDB berisi seluruhdim_productdengan kategori & atribut turunan- 3 query di atas dijalankan, hasilnya (atau screenshot) didokumentasikan
- Catatan penyesuaian soal heuristik kategori (bukan data asli) tercantum di README
Bagian 2 (Minggu, 4 jam): Redis Caching Layer + Penutup
Tahap 2: Implementasi Caching (±2.5 jam)
Target: 2 query “mahal” yang sudah dikenal sejak Minggu 1-2 — top 10 produk terlaris dan RFM summary (materi/minggu_2/latihan_eda_dan_mini_project.md).
nosql/redis_cache_layer.py:
import json
import time

import pandas as pd
import redis
from sqlalchemy import create_engine

engine = create_engine("postgresql://postgres:belajar@localhost:5432/postgres")
r = redis.Redis(host="localhost", port=6379, decode_responses=True)

TTL_SECONDS = 3600  # 1 jam -- selaras jadwal @daily pipeline Airflow (hari_4_redis.md)


def get_top_10_products(force_refresh: bool = False) -> list[dict]:
    cache_key = "cache:top_10_products"
    if not force_refresh:
        cached = r.get(cache_key)
        if cached is not None:
            return json.loads(cached)

    df = pd.read_sql("""
        SELECT stock_code, description, SUM(revenue) AS total_revenue
        FROM fact_sales f JOIN dim_product p USING (stock_code)
        WHERE is_return = FALSE
        GROUP BY stock_code, description
        ORDER BY total_revenue DESC LIMIT 10
    """, engine)
    result = df.to_dict(orient="records")
    r.set(cache_key, json.dumps(result), ex=TTL_SECONDS)
    return result


def get_rfm_summary(force_refresh: bool = False) -> list[dict]:
    cache_key = "cache:rfm_summary"
    if not force_refresh:
        cached = r.get(cache_key)
        if cached is not None:
            return json.loads(cached)

    df = pd.read_sql("""
        WITH rfm_raw AS (
            SELECT customer_id,
                   CURRENT_DATE - MAX(f.date_id::text::date) AS recency_days,
                   COUNT(DISTINCT invoice) AS frequency,
                   SUM(revenue) AS monetary
            FROM fact_sales f
            WHERE is_return = FALSE
            GROUP BY customer_id
        )
        SELECT *,
               NTILE(5) OVER (ORDER BY recency_days DESC) AS r_score,
               NTILE(5) OVER (ORDER BY frequency ASC) AS f_score,
               NTILE(5) OVER (ORDER BY monetary ASC) AS m_score
        FROM rfm_raw
    """, engine)
    result = df.to_dict(orient="records")
    r.set(cache_key, json.dumps(result), ex=TTL_SECONDS)
    return result


def benchmark(fn, label: str) -> float:
    r.delete(f"cache:{label}")  # pastikan mulai dari cache MISS
    t0 = time.time()
    fn(force_refresh=False)
    t_miss = time.time() - t0

    t0 = time.time()
    fn(force_refresh=False)
    t_hit = time.time() - t0

    print(f"{label}: cache MISS {t_miss:.4f}s, cache HIT {t_hit:.4f}s "
          f"({t_miss / max(t_hit, 1e-6):.1f}x lebih cepat)")
    return t_miss, t_hit


if __name__ == "__main__":
    benchmark(lambda force_refresh: get_top_10_products(force_refresh), "top_10_products")
    benchmark(lambda force_refresh: get_rfm_summary(force_refresh), "rfm_summary")
Jalankan & catat hasilnya:
python nosql/redis_cache_layer.py
Tulis Hasil Benchmark (±1 jam)
nosql/benchmark_results.md — catat angka aktual dari laptop kamu sendiri, plus 2-3 kalimat kesimpulan:
Benchmark: Query Langsung vs Redis Cache
| Query           | Cache MISS (query DB) | Cache HIT (dari Redis) | Speedup |
|-----------------|-----------------------|------------------------|---------|
| top_10_products |          ...s         |          ...s          |   ...x  |
| rfm_summary     |          ...s         |          ...s          |   ...x  |

Kesimpulan
...
Catatan jujur soal skala (konsisten dengan pola PySpark vs Pandas Minggu 3, BigQuery vs Postgres lokal Minggu 6): untuk data seukuran Online Retail II di pg-belajar lokal, query yang di-cache kemungkinan sudah cukup cepat bahkan tanpa cache (data muat nyaman, index dasar sudah membantu) — speedup dari Redis akan terlihat jelas secara relatif (cache hit hampir selalu jauh lebih cepat dari query database manapun, karena in-memory), tapi dampak absolutnya (berapa detik yang benar-benar dihemat) baru terasa signifikan di skala production dengan volume data & concurrent user yang jauh lebih besar — tulis observasi ini apa adanya di kesimpulan, jangan melebih-lebihkan dampak untuk skala mini project ini.
Tahap 3: STORAGE_STRATEGY.md (±2 jam)
Dokumen sintesis dari hari_5_storage_strategy.md — ini yang menyatukan seluruh keputusan arsitektur 8 minggu jadi 1 narasi koheren.
Storage Strategy — ecommerce-etl-pipeline
Diagram Polyglot Architecture
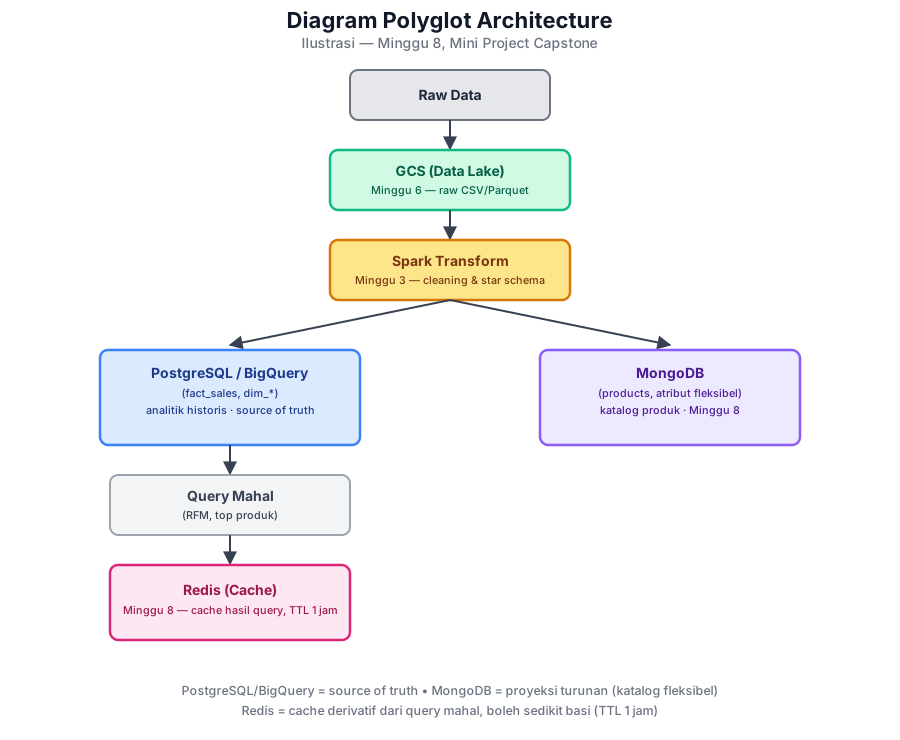
Lihat ilustrasi referensi di atas. Alur: Raw data -> GCS (data lake) -> Spark transform -> bercabang ke PostgreSQL/BigQuery (source of truth analitik) & MongoDB (katalog fleksibel) -> query mahal (RFM, top produk) di-cache di Redis (TTL 1 jam).
Tabel Keputusan
| Data | Disimpan di | Kenapa | Kenapa BUKAN alternatif lain |
|---|---|---|---|
| Raw CSV / Parquet backup | GCS (data lake) | Volume besar, murah, retensi jangka panjang | Bukan di Postgres – terlalu mahal untuk raw file yang jarang diakses langsung |
| fact_sales, dim_customer, dim_date | PostgreSQL (lokal) / BigQuery (cloud) | Terstruktur, relasi jelas, butuh JOIN & agregasi analitik | Bukan di MongoDB – relasi antar 4 tabel lebih natural di RDBMS |
| dim_product (katalog) | MongoDB | Atribut bervariasi per kategori, butuh skema fleksibel | Bukan cuma di RDBMS – akan menghasilkan banyak kolom NULL (hari_5_storage_strategy.md) |
| Hasil query top produk & RFM | Redis (cache) | Diakses berulang, mahal di-generate ulang tiap kali, boleh sedikit basi (TTL 1 jam) | Bukan disimpan permanen di Redis – source of truth tetap PostgreSQL/BigQuery |
Source of Truth & Sinkronisasi
dim_product ada di 2 tempat (PostgreSQL/BigQuery DAN MongoDB) – PostgreSQL/BigQuery tetap jadi source of truth (dihasilkan pipeline utama, build_star_schema.py). MongoDB adalah proyeksi turunan yang diperkaya kategori, disinkronkan lewat nosql/mongo_migration.py (idealnya dijalankan berkala, bukan sekali manual – di luar scope wajib mini project ini, tapi didokumentasikan sebagai limitasi yang disadari).
Isi lengkap dengan penjelasan bergaya hari_5_storage_strategy.md — jangan cuma tabel kosong, sertakan alasan naratif untuk tiap baris.
Tahap 4: README Final — Penutup Portfolio 8 Minggu (±1.5 jam)
Section baru “Project Journey” di README.md:
Project Journey (8 Minggu)
| Minggu | Fokus | Yang Ditambahkan |
|---|---|---|
| 1-2 | Analisis (SQL + Python) | Data cleaning, EDA, RFM analysis manual |
| 3 | Pipeline otomatis | PySpark + Airflow, star schema |
| 4 | Production-grade | Great Expectations (fail-fast), Kafka streaming demo |
| 5 | Governance | OpenMetadata catalog, lineage, GOVERNANCE.md |
| 6 | Cloud migration | GCS (data lake), BigQuery (data warehouse), IAM |
| 7 | Containerization | Custom Docker images, Kubernetes (1 komponen) |
| 8 | Polyglot storage | MongoDB (katalog fleksibel), Redis (caching), STORAGE_STRATEGY.md |
Diagram arsitektur final (diagrams/polyglot_architecture.png) — gabungkan semua komponen jadi 1 gambar: raw data → GCS → Spark → star schema (Postgres/BigQuery) → MongoDB/Redis → Airflow mengorkestrasi semuanya → Great Expectations menjaga kualitas → OpenMetadata mendokumentasikan → Docker/K8s menjalankan semuanya.
Link ke tiap dokumen relevan: GOVERNANCE.md (Minggu 5), STORAGE_STRATEGY.md (Minggu 8), cloud/setup_notes.md (Minggu 6).
Struktur Repo (Final)
ecommerce-etl-pipeline/
├── README.md                        # update final: Project Journey + diagram lengkap
├── STORAGE_STRATEGY.md               # baru
├── GOVERNANCE.md
├── dags/
│   └── ecommerce_etl_dag.py
├── spark_jobs/
│   ├── clean_transform.py
│   ├── build_star_schema.py
│   ├── requirements.txt
│   ├── Dockerfile
│   └── .dockerignore
├── great_expectations/
│   ├── build_suite.py
│   └── expectations/
│       └── ecommerce_suite.json
├── streaming-demo/
│   ├── producer.py
│   ├── consumer.py
│   ├── requirements.txt
│   ├── Dockerfile
│   └── .dockerignore
├── governance/
├── cloud/
│   ├── iam_policy.json
│   ├── lifecycle.json
│   ├── bigquery_queries/
│   │   └── rfm_analysis.sql
│   └── setup_notes.md
├── k8s/
│   ├── consumer-deployment.yaml
│   └── consumer-service.yaml
├── nosql/                             # baru
│   ├── mongo_migration.py            # baru
│   ├── redis_cache_layer.py          # baru
│   └── benchmark_results.md          # baru
├── docker-compose.yml
├── Dockerfile
├── data/
└── diagrams/
    ├── star_schema.png
    ├── pipeline_architecture_v2.png
    ├── data_lineage.png
    ├── cloud_architecture.png
    ├── containerization_architecture.png
    └── polyglot_architecture.png     # baru
Kriteria “Selesai” untuk Minggu 8 (Capstone)
dim_producttermigrasi ke MongoDB dengan atribut fleksibel per kategori (heuristik kategori terdokumentasi jujur sebagai simplifikasi, bukan data asli)- Redis caching aktif untuk top 10 produk & RFM summary, dengan TTL yang masuk akal
nosql/benchmark_results.mdberisi angka aktual + kesimpulan jujur soal skalaSTORAGE_STRATEGY.mdmenjelaskan setiap keputusan storage di repo (bukan cuma MongoDB/Redis, tapi seluruh polyglot architecture 8 minggu) dengan tabel “kenapa X bukan Y”README.mdfinal berisi section “Project Journey” yang merangkum evolusi 8 minggu, dan diagram arsitektur yang menunjukkan semua komponen terhubung- Bisa menjelaskan ke orang lain (simulasi interview): untuk setiap tool di repo ini (Postgres, Spark, Airflow, Great Expectations, Kafka, OpenMetadata, GCS, BigQuery, Docker, Kubernetes, MongoDB, Redis), alasan kenapa tool itu dipilih dan masalah spesifik apa yang dijawabnya — bukan cuma bisa menjalankannya
🎉 Portfolio Selesai
Kalau semua tercentang di sini dan di 7 kriteria “Selesai” minggu-minggu sebelumnya, repo ecommerce-etl-pipeline sekarang adalah bukti nyata kemampuan iterative system design end-to-end — dari analisis manual (Minggu 1) sampai arsitektur polyglot production-minded (Minggu 8), dengan setiap keputusan terdokumentasi alasannya. Ini jauh lebih kuat untuk portfolio/interview dibanding kumpulan project kecil terpisah, karena menunjukkan proses berpikir yang berkembang, bukan cuma daftar tool yang pernah disentuh.
Langkah lanjutan yang wajar (di luar cakupan roadmap 8 minggu ini, tapi baik dipikirkan): deploy sungguhan ke cloud (bukan cuma lokal + migrasi parsial Minggu 6), CI/CD untuk docker build/testing otomatis, atau mendalami salah satu area (streaming real-time, data governance, atau infra-as-code) sebagai spesialisasi lanjutan berdasarkan minat yang paling terasa selama 8 minggu ini.